互聯網數據服務 構建安全、可擴展且高性能的大規模數據處理、存儲與網絡服務體系
引言
隨著移動互聯網、物聯網、人工智能等技術的快速發展,全球數據量呈現爆炸式增長。互聯網數據服務作為支撐數字經濟的基礎設施,需要處理海量數據、存儲PB級甚至EB級信息,并提供高并發的網絡服務。在這一背景下,安全性、可擴展性和性能成為衡量互聯網數據服務能力的核心指標。本文將探討如何設計并實現一個能夠支持大規模數據處理、存儲和網絡服務的互聯網數據服務平臺。
大規模數據處理
互聯網數據服務每天需要處理來自各種來源的數據:用戶行為日志、交易記錄、傳感器數據、社交媒體內容等。這些數據具有大體量(Volume)、多樣性(Variety)、高速性(Velocity)和 value(Value)等特征。
數據處理架構
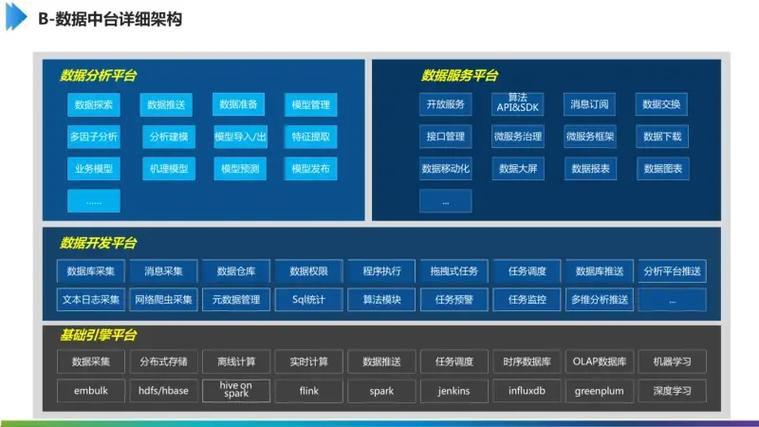
為了高效處理大規模數據,通常采用Lambda架構或Kappa架構,結合批處理和流處理。例如:
- 批處理層:使用Hadoop、Spark等框架對歷史數據進行離線分析。
- 流處理層:使用Flink、Storm、Kafka Streams等實現實時計算。
- 服務層:將處理結果存儲到數據庫或緩存中,供上層應用查詢。
在大規模場景下,數據分區、并行計算、任務調度和資源管理是關鍵挑戰。YARN、Kubernetes等資源調度系統能夠 dynamically 分配計算資源,提高集群利用率。
大規模數據存儲
存儲是互聯網數據服務的基石,需要兼顧容量、吞吐量、延遲和持久性。根據數據類型和訪問模式,通常采用分層存儲策略:
- 熱存儲:如Redis、Memcached,用于緩存和高速訪問。
- 溫存儲:如HBase、Cassandra,用于中等規模結構化數據。
- 冷存儲:如HDFS、S3、OSS,用于海量歷史數據歸檔。
分布式存儲系統
分布式存儲通過數據分片(Sharding)和副本(Replication)實現可擴展性和高可用性。例如:
- HDFS:主從架構,適合大文件順序讀寫。
- Ceph:統一的分布式存儲系統,支持對象、塊和文件存儲。
- TiDB:分布式SQL數據庫,結合了OLTP和OLAP能力。
存儲系統需要保證數據一致性(強一致或最終一致)、容錯性和自動恢復能力。
大規模網絡服務
互聯網數據服務需要承受每秒數百萬甚至數千萬的請求。為了提供低延遲、高可用的網絡服務,架構設計需考慮:
- 負載均衡:使用LVS、Nginx、HAProxy或云負載均衡器分發流量。
- CDN:將靜態內容緩存至邊緣節點,減少回源壓力。
- 微服務與API網關:將系統拆分為細粒度服務,通過API網關統一入口,實現鑒權、限流、熔斷等。
- 異步與消息隊列:使用Kafka、RabbitMQ等解耦服務,削峰填谷。
安全性保障
安全性是互聯網數據服務的生命線,涉及數據機密性、完整性和可用性。關鍵措施包括:
- 身份認證與授權:OAuth 2.0、JWT、RBAC等機制。
- 數據加密:傳輸層TLS/SSL,存儲層AES加密,密鑰管理KMS。
- 網絡安全:防火墻、WAF、DDoS防護、VPC隔離。
- 審計與監控:日志記錄、行為分析、入侵檢測。
- 合規性:遵守GDPR、CCPA、等級保護等法規。
可擴展性設計
可擴展性決定了系統能否隨著業務增長而平滑擴容。關鍵原則包括:
- 水平擴展:通過增加節點而非提升單機性能來擴展。
- 無狀態服務:將狀態外置到存儲層,使服務層易于伸縮。
- 分片與分區:將數據和服務按規則拆分,避免單點瓶頸。
- 自動化運維:利用Kubernetes、Terraform等實現彈性伸縮和自動部署。
性能優化
性能直接影響到用戶體驗和資源成本。優化手段涵蓋:
- 緩存:多級緩存(本地緩存、分布式緩存、CDN)。
- 索引與查詢優化:合理設計數據庫索引,使用列式存儲。
- 并發與異步:非阻塞I/O、協程、響應式編程。
- 硬件加速:SSD、RDMA、GPU、DPU等。
- 性能測試與調優:持續壓測,基于監控數據定位瓶頸。
結論
構建支持大規模數據處理、存儲和網絡服務的互聯網數據服務平臺,需要在安全性、可擴展性和性能之間取得平衡。通過采用分布式架構、分層存儲、流批一體計算、微服務、加密與訪問控制等技術,可以打造一個彈性、可靠、高效的數據服務基礎設施,為上層業務提供強有力的支撐。隨著5G、邊緣計算和AI的融合,互聯網數據服務將邁向更智能、更自動化的新階段。
如若轉載,請注明出處:http://m.cdrzx.com/product/56.html
更新時間:2026-10-15 05:25:43